


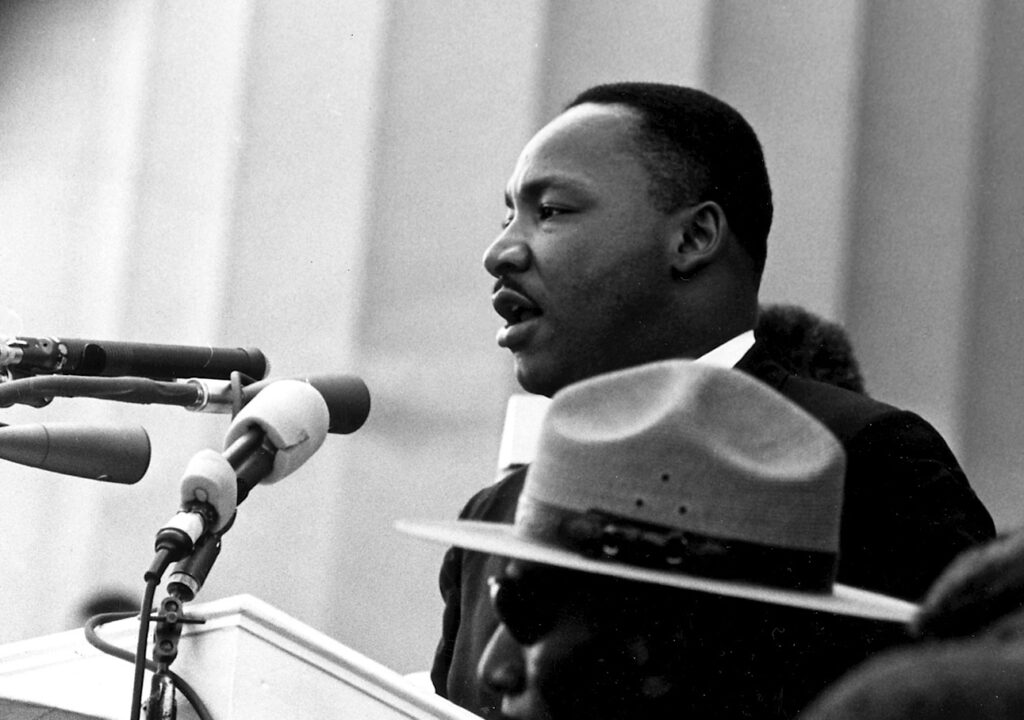
Peut-on réellement savoir si un texte a été écrit par ChatGPT grâce à un détecteur d’IA ? Une étude publiée en 2025 montre les limites parfois spectaculaires de ces logiciels : deux outils ont estimé que le célèbre discours « I have a dream », prononcé par Martin Luther King en 1963, avait plus de 84 % de chances d’avoir été généré par une intelligence artificielle.
C’est un résultat qui résume à lui seul les difficultés rencontrées par les logiciels censés reconnaître les textes produits par intelligence artificielle. Soumis à plusieurs détecteurs d’IA, le discours « I have a dream » de Martin Luther King a été identifié par certains d’entre eux comme un contenu largement artificiel.
Problème évident : Martin Luther King a prononcé ce discours le 28 août 1963, à Washington, plusieurs décennies avant l’apparition de ChatGPT et des grands modèles de langage contemporains.
L’expérience figure dans une étude publiée en octobre 2025 dans la revue scientifique Information par Tadesse G. Wakjira et plusieurs chercheurs américains et canadiens. Leur objectif était d’évaluer la fiabilité de six outils de détection d’intelligence artificielle, gratuits ou payants.
Les chercheurs ont notamment utilisé une transcription du discours de Martin Luther King provenant des Archives nationales américaines.
Le résultat est pour le moins déroutant.
ZeroGPT.com a évalué à 87,7 % la probabilité que le discours ait été produit par une intelligence artificielle. Un autre service, ZeroGPT.net, est arrivé à un résultat comparable avec 84,4 %.
Les quatre autres détecteurs testés ont, à l’inverse, correctement identifié le discours comme étant d’origine humaine.
Une même œuvre, six logiciels et des verdicts radicalement différents : l’expérience illustre le principal problème pointé par les chercheurs. Un score fourni par ce type d’outil ne constitue pas, à lui seul, une preuve permettant d’établir l’origine d’un texte.
Des textes de Harvard et du MIT soupçonnés d’être artificiels
Les chercheurs ne se sont pas limités au discours de Martin Luther King. Leur corpus comportait 35 textes de différentes natures.
Pour représenter les productions humaines, l’équipe a notamment sélectionné des pages institutionnelles d’universités prestigieuses comme Harvard, Cambridge et le Massachusetts Institute of Technology, ainsi que des articles de la BBC et des résumés de publications scientifiques datant d’avant la démocratisation de ChatGPT.
Les chercheurs ont également intégré plusieurs productions générées par ChatGPT-4o, dont un texte volontairement absurde, un autre contenant de nombreuses erreurs et un troisième ayant été réécrit.
Le protocole retenait un seuil simple : lorsqu’un détecteur attribuait une probabilité supérieure à 50 % à l’origine artificielle d’un texte, celui-ci était considéré comme généré par une IA.
Les erreurs observées ne se limitent pas à quelques cas isolés.
Certaines pages de présentation de grandes universités ont ainsi été considérées comme étant entièrement générées par intelligence artificielle. Plus surprenant encore, cinq des six outils étudiés ont attribué à une machine le célèbre article scientifique consacré à l’apprentissage profond signé par Yann LeCun, Yoshua Bengio et Geoffrey Hinton.
L’exactitude globale des détecteurs variait considérablement selon les logiciels : de seulement 14,3 % pour le moins performant à 71,4 % pour le meilleur dans cette expérience.
Un seul mot peut bouleverser le résultat
L’étude met également en évidence l’extrême sensibilité de certains détecteurs à des modifications pourtant minimes.
Les chercheurs ont effectué une expérience sur un texte provenant de l’université Stanford. Dans sa version initiale, ZeroGPT.com estimait à 69,51 % la probabilité qu’il ait été produit par une intelligence artificielle.
La suppression d’un seul mot a suffi à bouleverser complètement le diagnostic : le même outil a alors considéré le texte comme 100 % humain.
À l’inverse, certains contenus effectivement produits par ChatGPT-4o ont échappé à la détection. Des textes volontairement absurdes ou remplis de fautes ont ainsi pu être classés comme humains.
L’une des explications avancées par les auteurs concerne les caractéristiques stylistiques recherchées par ces systèmes. Une écriture particulièrement régulière, structurée et soignée peut présenter certaines propriétés statistiques associées aux productions des modèles de langage.
Le problème est que ces caractéristiques existent naturellement dans de nombreux textes humains. Les publications universitaires, les documents institutionnels ou encore les discours préparés font justement l’objet d’un travail important de rédaction et de révision.
Un problème lorsqu’il faut accuser quelqu’un de triche
Les conséquences deviennent beaucoup plus sérieuses lorsque ces logiciels quittent le cadre expérimental. Un détecteur d’IA peut notamment être utilisé pour examiner le devoir d’un étudiant, un texte professionnel, une candidature ou une œuvre littéraire. Un faux positif peut alors conduire à soupçonner une personne d’avoir utilisé une intelligence artificielle alors que son travail est authentiquement humain.
Les chercheurs considèrent que les outils examinés dans leur étude n’atteignent pas un niveau de fiabilité suffisant pour servir seuls dans des décisions aux conséquences importantes, notamment lorsqu’il est question de fraude académique ou de recrutement.
Ils recommandent notamment la mise en place de systèmes d’évaluation transparents et le maintien d’une vérification humaine lorsque ces scores sont utilisés.
L’étude présente cependant elle-même des limites importantes. Son corpus ne comporte que 35 textes et seulement trois productions générées par intelligence artificielle. Les résultats concernent également une sélection d’outils grand public testés à un moment précis.
Des détecteurs plus récents affichent de meilleurs résultats
Le secteur évolue en effet à grande vitesse. Science & Vie rapporte qu’en juillet 2026, l’institut de recherche Epoch AI a évalué plusieurs détecteurs plus récents, dont Pangram, GPTZero et Originality.ai, à partir d’un corpus de textes humains et artificiels.
Sur 495 textes rédigés par des humains, Pangram et GPTZero n’en auraient identifié aucun à tort comme artificiel lors de cette évaluation. Originality.ai aurait enregistré un taux d’erreur de 3,8 % sur ces textes humains.
Ces performances ne règlent toutefois pas entièrement le problème de la détection.
Lorsque les modèles d’intelligence artificielle étaient chargés d’imiter le style d’un auteur déterminé, environ 13 % des productions artificielles auraient échappé aux détecteurs testés par Epoch AI.
La course technologique se déroule donc dans les deux sens. Les modèles génératifs progressent et peuvent produire des textes de plus en plus variés, tandis que les systèmes chargés de les identifier doivent continuellement être adaptés.
L’affaire du discours de Martin Luther King constitue ainsi un exemple spectaculaire, mais surtout pédagogique, des limites d’une détection purement automatisée. Un score de 80 %, 90 % ou même davantage ne raconte pas nécessairement l’histoire réelle d’un texte. Il représente le résultat statistique produit par un logiciel à partir de ses propres critères.
Dans le cas de « I have a dream », l’Histoire offre heureusement un arbitre autrement plus fiable : le discours avait déjà été prononcé depuis plusieurs décennies lorsque l’intelligence artificielle générative moderne est entrée dans nos vies.
Sources :
Science & Vie, Laurie Henry, « Selon un détecteur d’IA, le discours “I have a dream” de Martin Luther King a été écrit par une IA », publié le 5 octobre 2026.
Tadesse G. Wakjira, Ibrahim A. Tijani, M. Shahria Alam, Mustafa Mashal et Mohammad Khalad Hasan, « Can We Trust AI Content Detection Tools for Critical Decision-Making? », Information, 2025.
Epoch AI, étude comparative sur les faux positifs et faux négatifs des détecteurs d’IA, juillet 2026.